先說結論:大模型會給出每次不同的結果,但這不等於公平隨機。
這次讓六個大模型直接搖出 3,072 個有效六爻卦。若它們真的像三枚公平銅錢一樣工作,64 卦長期看應該差不多平均,每卦約出現 48 次。實際第一名水火既濟出現了 482 次,第二名乾為天出現了 330 次;有些卦卻極少出現。更關鍵的是,只換一種問法,同一個模型最常生成的卦就可能完全改變。
所以這次測到的不是一個永恆不變的“模型性格”,而是更具體的事實:在這四種提示方式下,這些模型生成 0 和 1 時存在明顯、而且受問法影響的偏好。
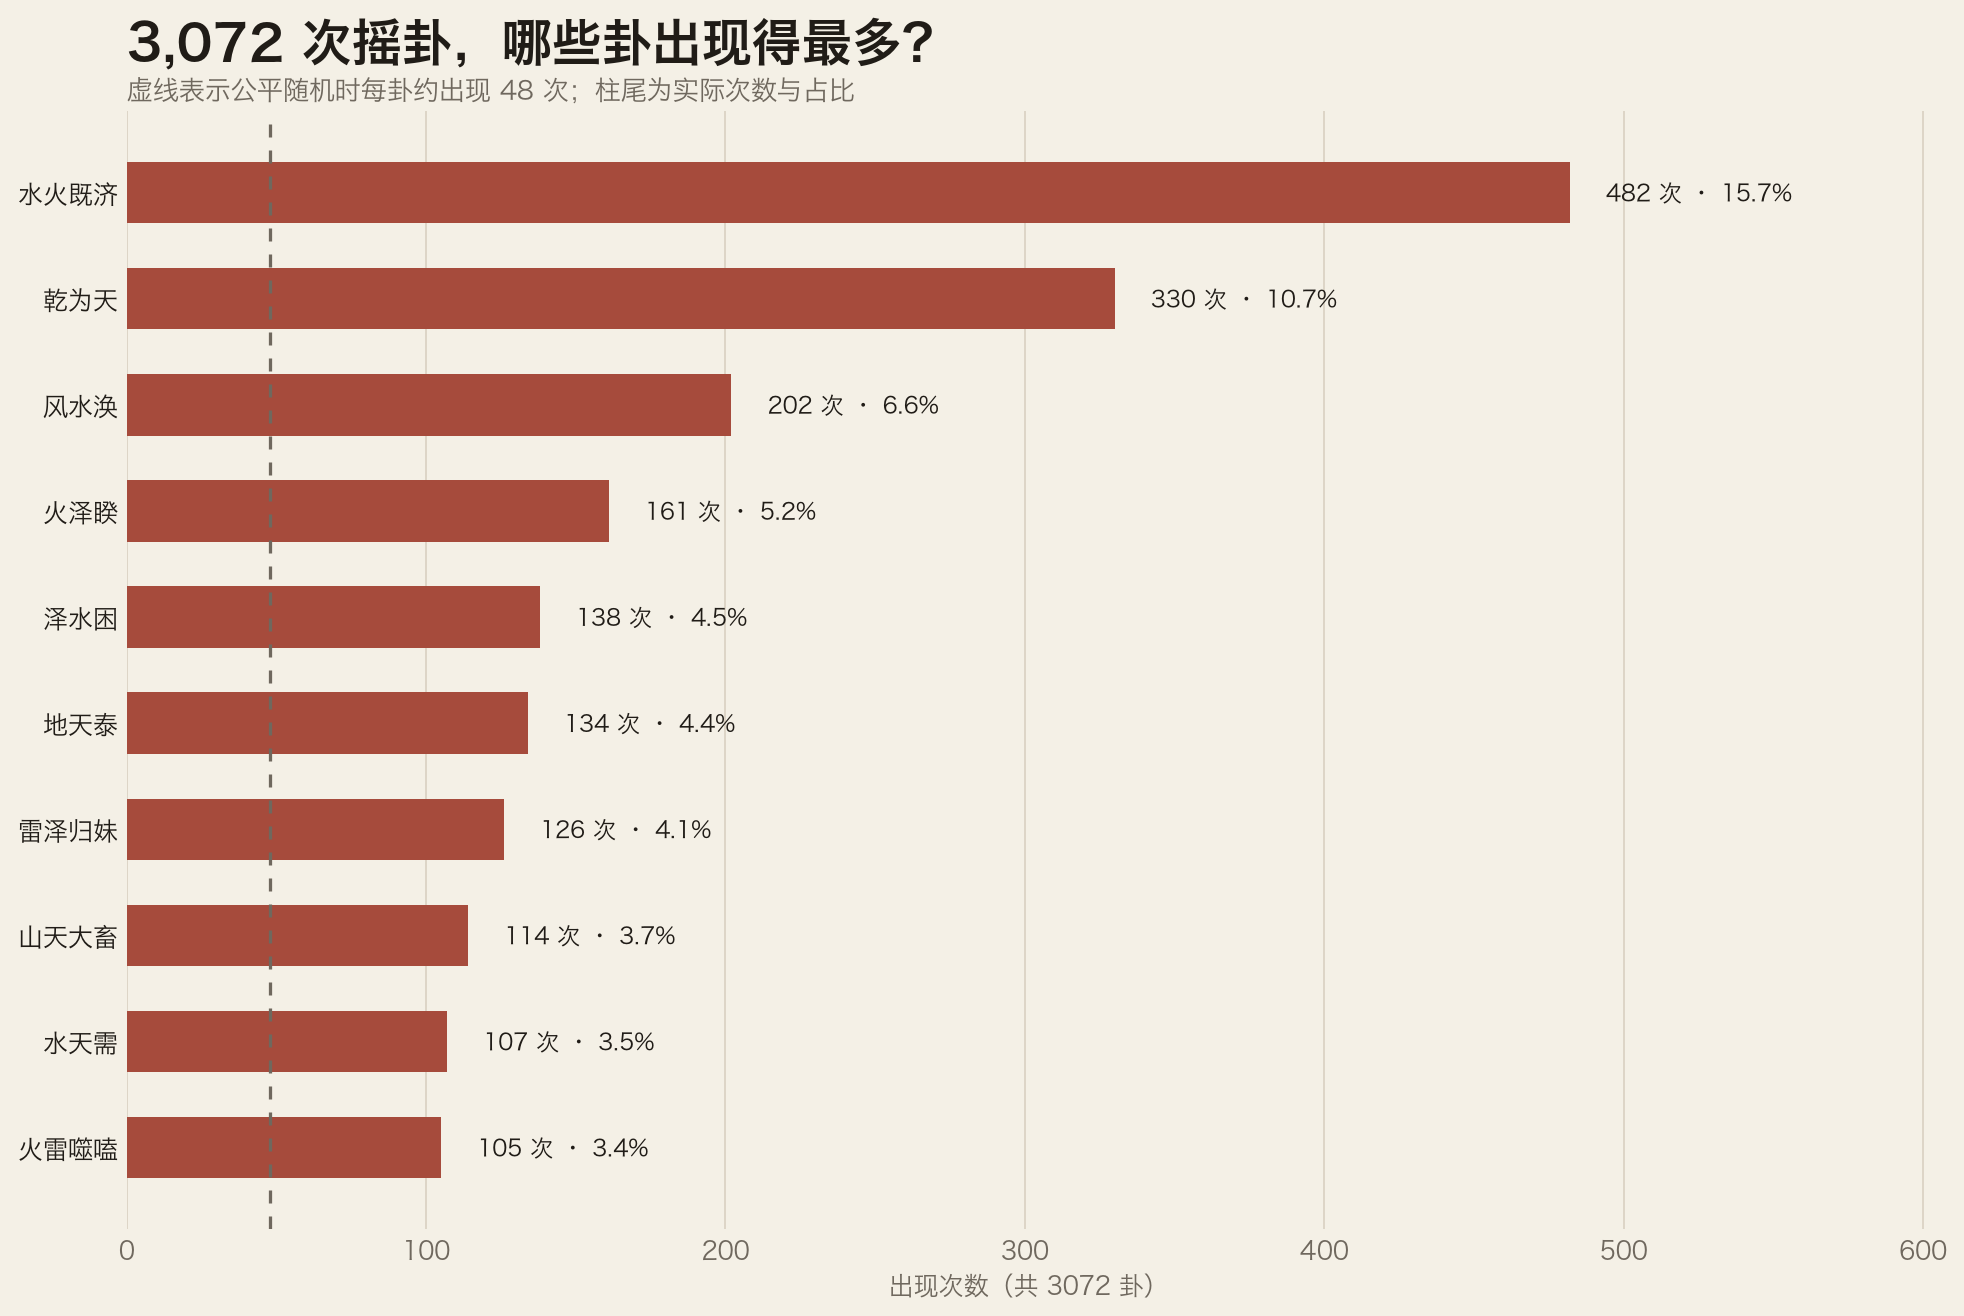
圖一:全部模型和問法合併後的前十卦。虛線表示公平隨機時每卦約 48 次。
實驗到底怎麼做
實驗裡不是先讓程序擲銅錢,再把卦交給模型。每一枚“銅錢”的 0 或 1 都由模型直接生成。程序只負責三件事:檢查格式、按固定規則排卦、統計結果。它不會在模型失敗時偷偷補隨機數,也不會改寫有效結果。
這次共測試六個通過 OpenRouter 實際調用的模型:
- GPT-5.5:
openai/gpt-5.5 - Claude Opus 4.8:
anthropic/claude-opus-4.8 - Gemini 3.1 Pro:
google/gemini-3.1-pro-preview - DeepSeek V4 Pro:
deepseek/deepseek-v4-pro - Qwen 3.7 Max:
qwen/qwen3.7-max - GLM-5.2:
z-ai/glm-5.2
每個模型接受四種問法,每種問法保留 128 個有效完整卦。因此是:
6 個模型 × 4 種問法 × 128 個有效卦 = 3,072 個完整卦。
四種問法分別是:
- 說到銅錢,一次生成六爻:明確告訴模型模擬三枚銅錢,並一次給出六爻。
- 不說銅錢,一次生成六爻:只要求給出六組 0/1,不使用銅錢敘事。
- 說到銅錢,一次給出全部數字:連續輸出組成一個卦所需的 18 位 0/1。
- 說到銅錢,逐爻生成:每次只生成一爻的三枚銅錢,六次合成一個卦。
所有組都使用相同的有效樣本數。無效格式只會重試,不進入統計;最終比較的是每組 128 個有效卦,而不是誰更容易按格式回答。
總體結果:第一名是公平預期的十倍
3,072 個結果平均分給 64 卦時,每卦應為 48 次。實際前十名如下:
| 排名 | 卦象 | 出現次數 | 佔全部結果 |
|---|---|---|---|
| 1 | 水火既濟 | 482 | 15.7% |
| 2 | 乾為天 | 330 | 10.7% |
| 3 | 風水渙 | 202 | 6.6% |
| 4 | 火澤睽 | 161 | 5.2% |
| 5 | 澤水困 | 138 | 4.5% |
| 6 | 地天泰 | 134 | 4.4% |
| 7 | 雷澤歸妹 | 126 | 4.1% |
| 8 | 山天大畜 | 114 | 3.7% |
| 9 | 水天需 | 107 | 3.5% |
| 10 | 火雷噬嗑 | 105 | 3.4% |
水火既濟的 482 次,是公平預期 48 次的約 10 倍。總體分佈的卡方統計量是 8,553.0(63 個自由度),偏離均勻分佈的程度遠不是普通的小幅波動。
這裡的“偏好”是一個很樸素的說法:某些卦明顯更常被生成。它不是模型能力排名,也不是在說哪一卦“更好”。
問法一換,最常出現的卦也會換
把四種問法分開看,差異更清楚:
| 問法 | 最常出現的卦 | 次數 | 該問法中的比例 |
|---|---|---|---|
| 說到銅錢,一次生成六爻 | 水火既濟 | 179 / 768 | 23.3% |
| 不說銅錢,一次生成六爻 | 水火既濟 | 200 / 768 | 26.0% |
| 說到銅錢,一次給出全部數字 | 水火既濟 | 103 / 768 | 13.4% |
| 說到銅錢,逐爻生成 | 乾為天 | 330 / 768 | 43.0% |
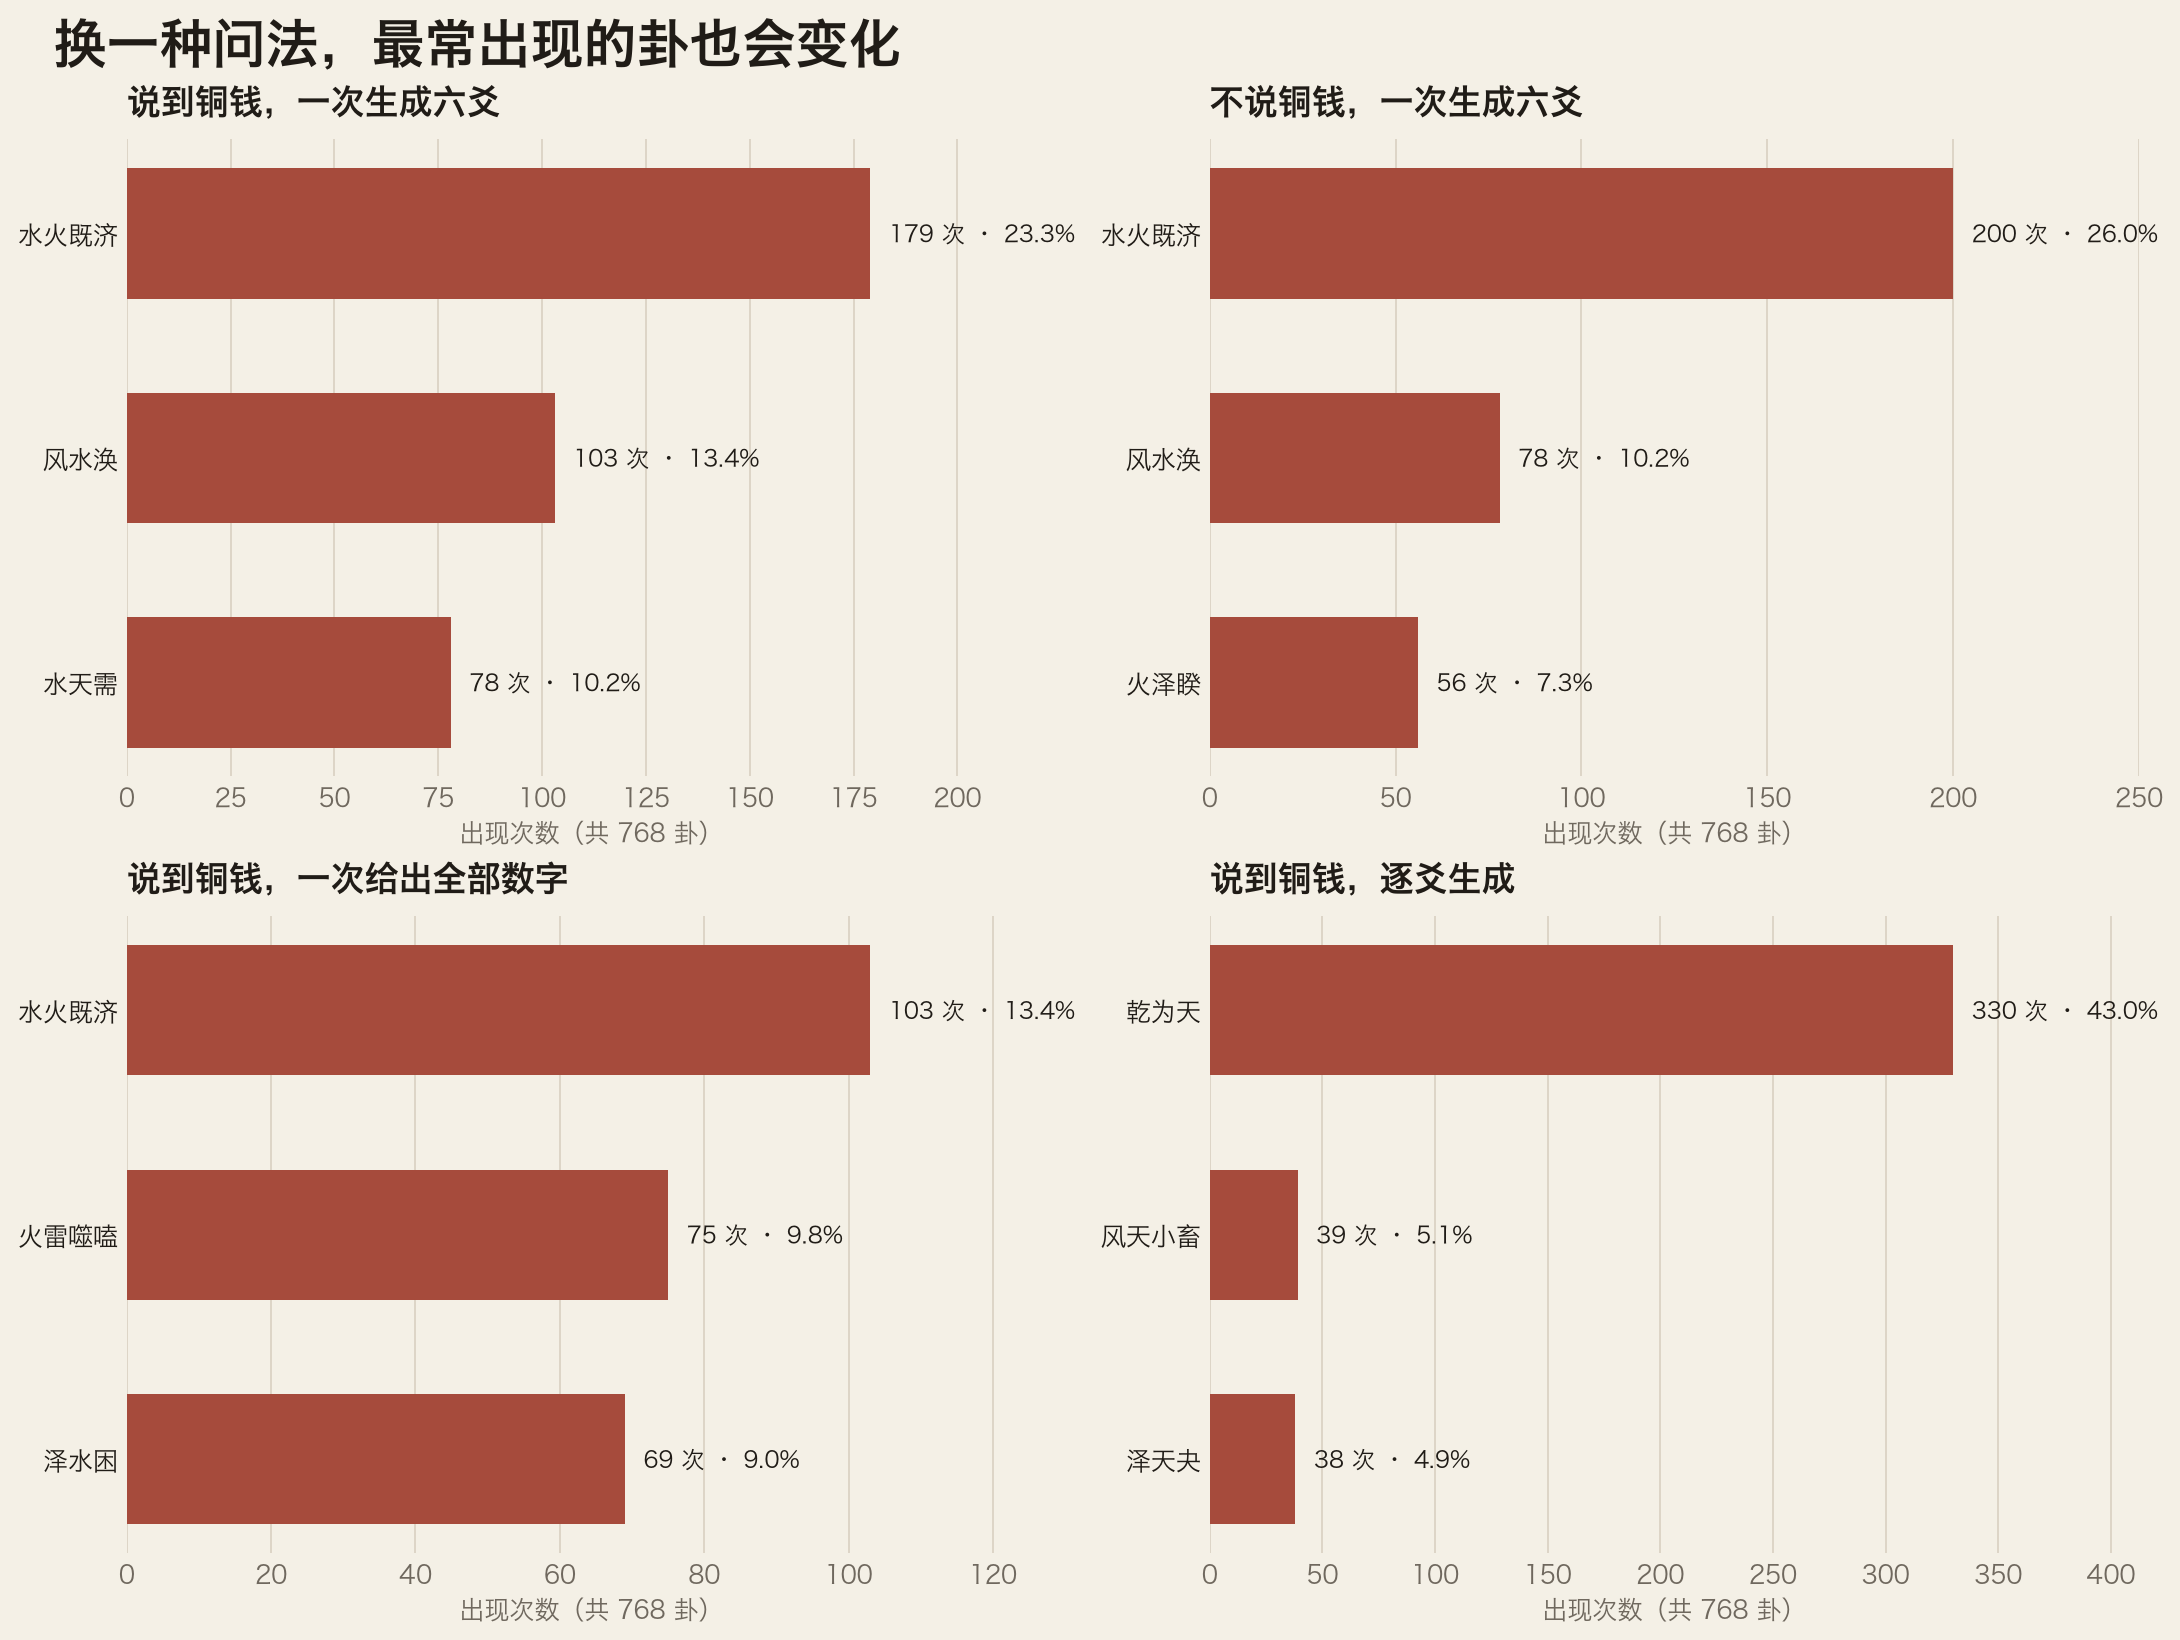
圖二:每種問法都有 768 個有效卦。逐爻生成時,整體第一名從水火既濟變成了乾為天。
“一次生成”和“逐爻生成”看起來只是輸出方式不同,但對語言模型來說並不是同一件事。一次寫完時,模型在同一段上下文裡續寫多位數字;逐爻請求時,生成邊界和可見上下文都變了,後面的概率也隨之改變。
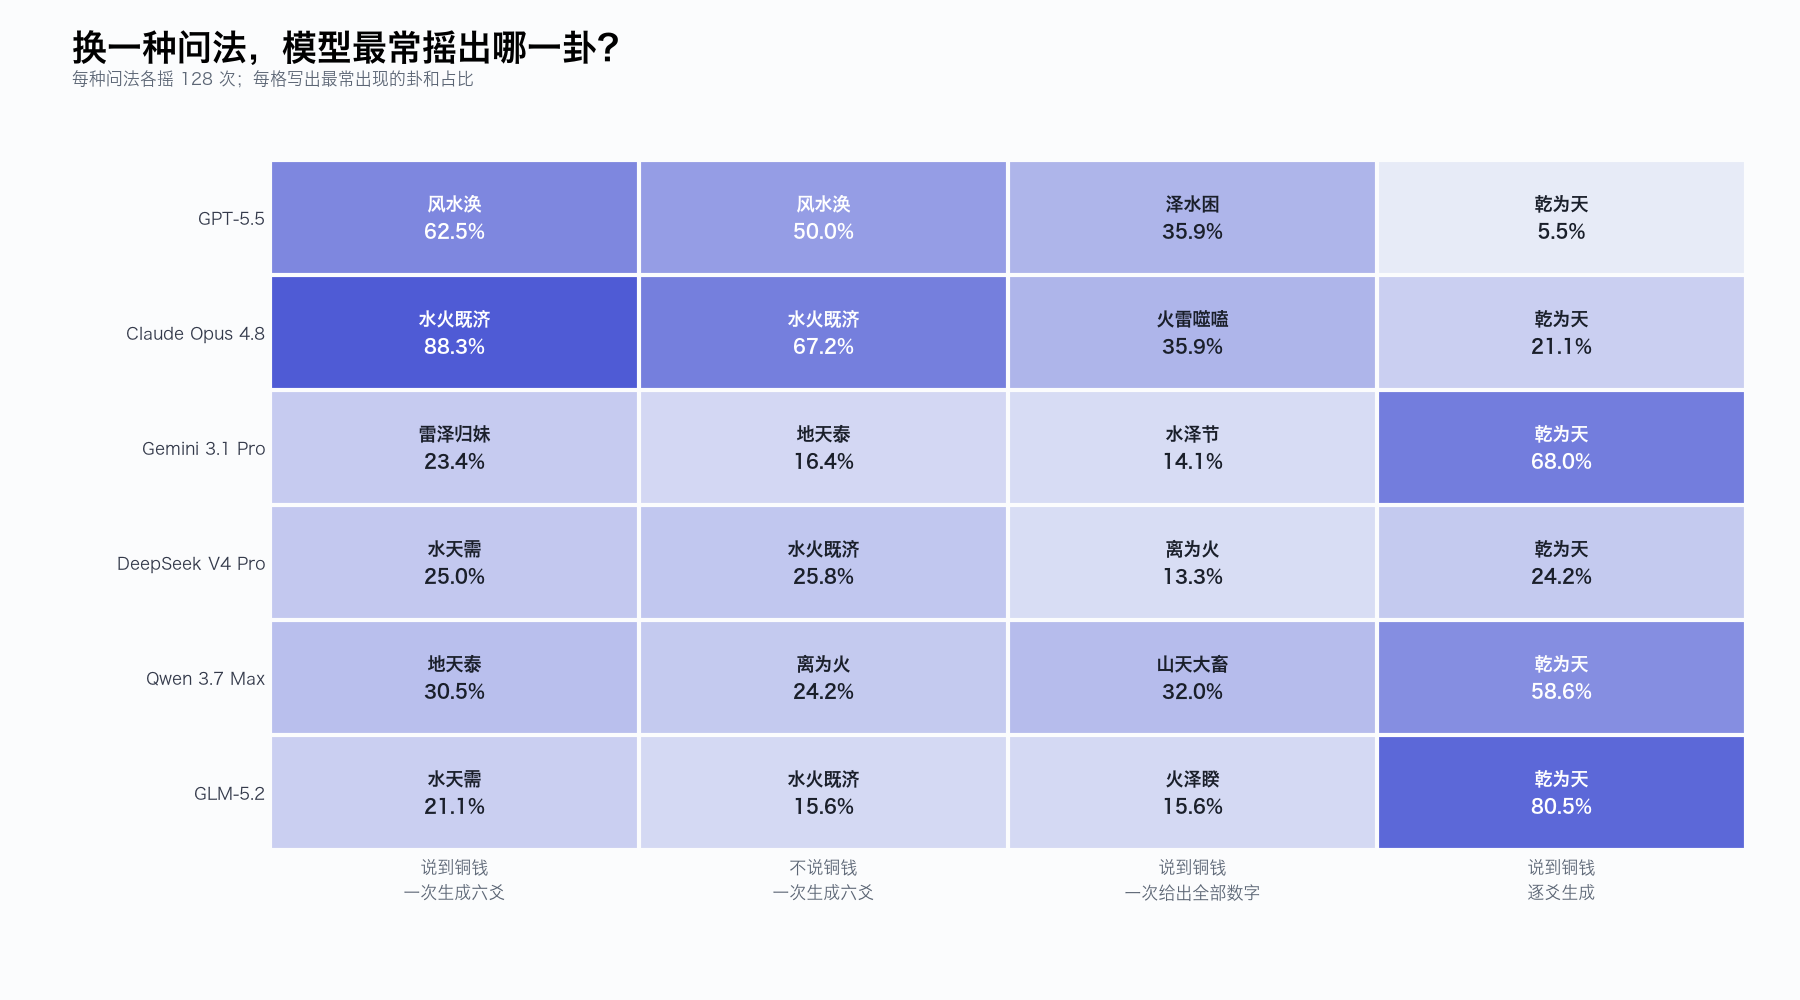
圖三:每一行是一個模型,每一列是一種問法;格子直接寫出該組最常生成的卦。
六個模型,各自最常生成什麼
把四種問法合併,每個模型都有 512 個有效卦。它們的整體第一名是:
| 模型 | 最常出現的卦 | 次數 | 該模型中的比例 |
|---|---|---|---|
| GPT-5.5 | 風水渙 | 164 / 512 | 32.0% |
| Claude Opus 4.8 | 水火既濟 | 237 / 512 | 46.3% |
| Gemini 3.1 Pro | 乾為天 | 87 / 512 | 17.0% |
| DeepSeek V4 Pro | 水風井 | 47 / 512 | 9.2% |
| Qwen 3.7 Max | 乾為天 | 75 / 512 | 14.6% |
| GLM-5.2 | 乾為天 | 103 / 512 | 20.1% |
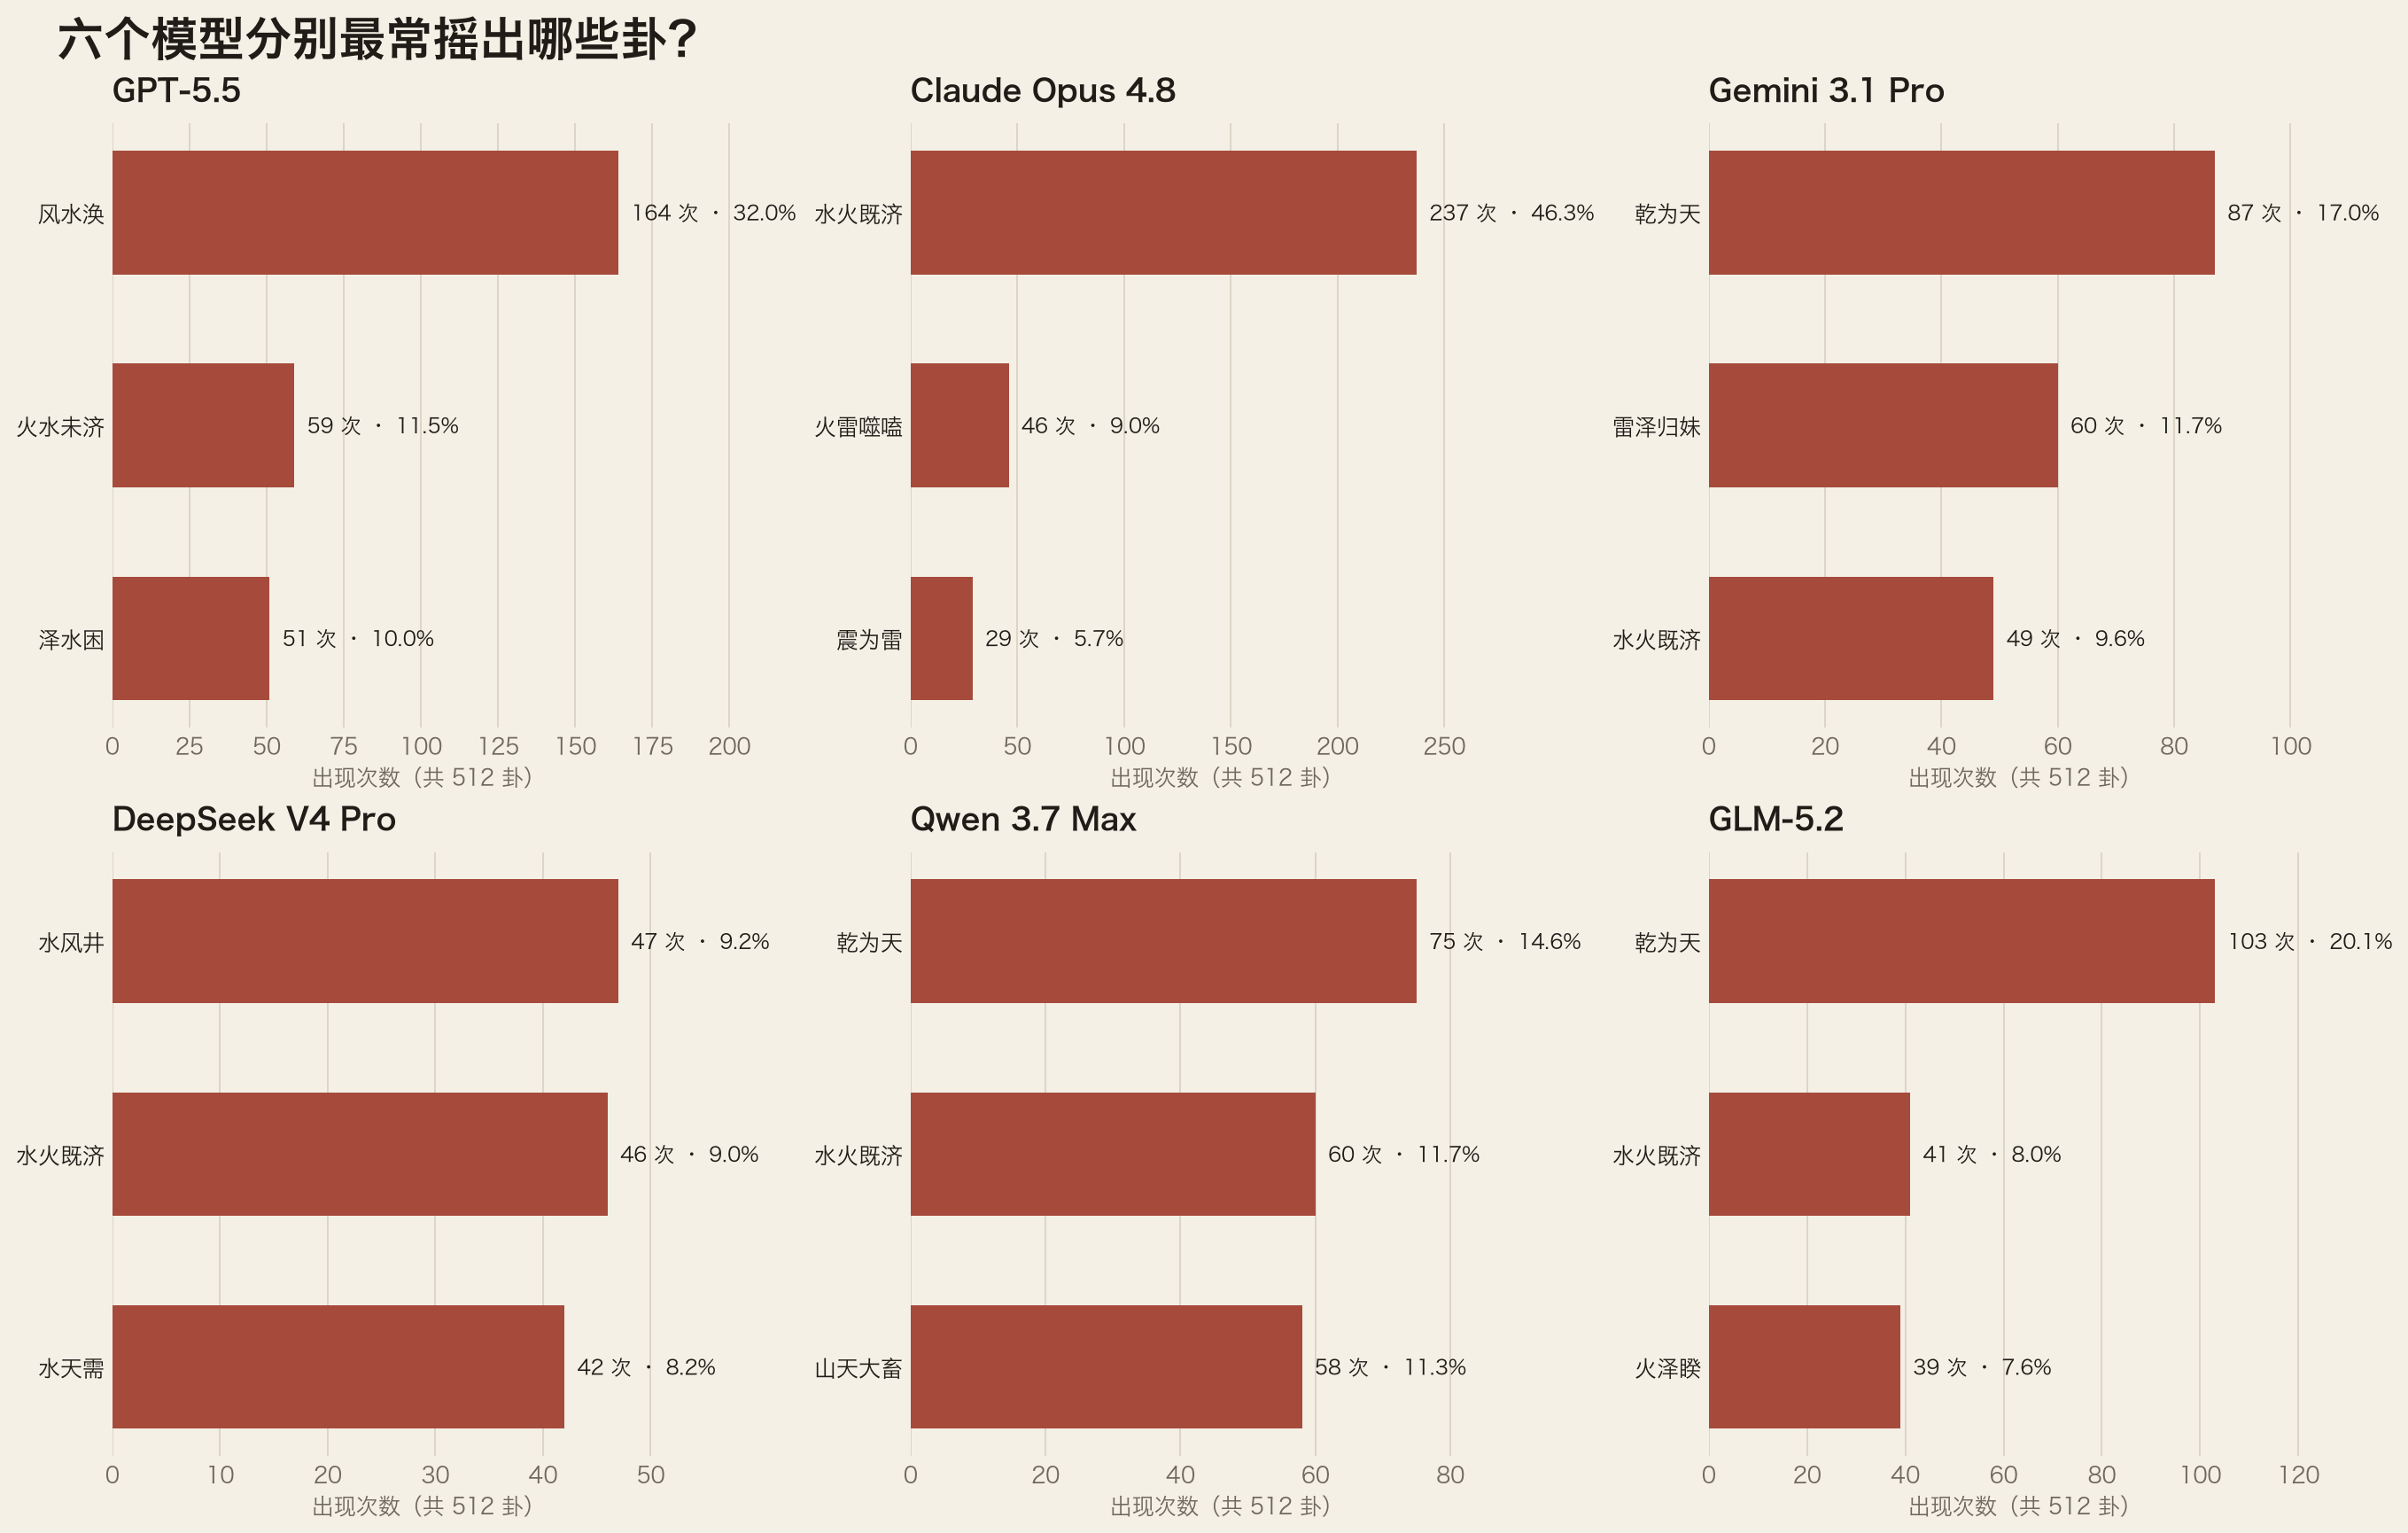
圖四:這是四種問法合併後的描述統計,不是模型能力排名。
不同模型的偏好並不相同。Claude Opus 4.8 的結果高度集中在水火既濟;GPT-5.5 更常生成風水渙;Gemini、Qwen 和 GLM 合併後都以乾為天居首;DeepSeek 的分佈相對分散,整體第一名是水風井。
24 組結果:偏好屬於“模型 × 問法”
只看總榜會掩蓋一個重要事實:偏好不是只屬於模型,也不是只屬於提示詞,而是兩者共同形成的。下面列出全部 24 組各自的第一名;每一組都來自 128 個有效卦。四個數字依次對應“說銅錢一次六爻、不說銅錢一次六爻、一次給出 18 位數字、逐爻生成”。
GPT-5.5
- 說銅錢、一次六爻:風水渙 80(62.5%)
- 不說銅錢、一次六爻:風水渙 64(50.0%)
- 一次給出 18 位數字:澤水困 46(35.9%)
- 逐爻生成:乾為天 7(5.5%)
Claude Opus 4.8
- 說銅錢、一次六爻:水火既濟 113(88.3%)
- 不說銅錢、一次六爻:水火既濟 86(67.2%)
- 一次給出 18 位數字:火雷噬嗑 46(35.9%)
- 逐爻生成:乾為天 27(21.1%)
Gemini 3.1 Pro
- 說銅錢、一次六爻:雷澤歸妹 30(23.4%)
- 不說銅錢、一次六爻:地天泰 21(16.4%)
- 一次給出 18 位數字:水澤節 18(14.1%)
- 逐爻生成:乾為天 87(68.0%)
DeepSeek V4 Pro
- 說銅錢、一次六爻:水天需 32(25.0%)
- 不說銅錢、一次六爻:水火既濟 33(25.8%)
- 一次給出 18 位數字:離為火 17(13.3%)
- 逐爻生成:乾為天 31(24.2%)
Qwen 3.7 Max
- 說銅錢、一次六爻:地天泰 39(30.5%)
- 不說銅錢、一次六爻:離為火 31(24.2%)
- 一次給出 18 位數字:山天大畜 41(32.0%)
- 逐爻生成:乾為天 75(58.6%)
GLM-5.2
- 說銅錢、一次六爻:水天需 27(21.1%)
- 不說銅錢、一次六爻:水火既濟 20(15.6%)
- 一次給出 18 位數字:火澤睽 20(15.6%)
- 逐爻生成:乾為天 103(80.5%)
GLM-5.2 是最直觀的例子:說到銅錢並一次生成六爻時,第一名是水天需;改成一次輸出 18 位數字,第一名變成火澤睽;改成逐爻生成,乾為天佔到 80.5%。模型沒有換,生成方式一換,結果就變了。
不只是某一卦多:數字模板也會重複
模型逐字生成 0 和 1 時,某些局部組合會比其他組合更容易被續寫。相同的六爻數字模板反覆出現,最終自然會聚集到少數卦象。下面這張圖展示了各組中最常見模板的重複程度。
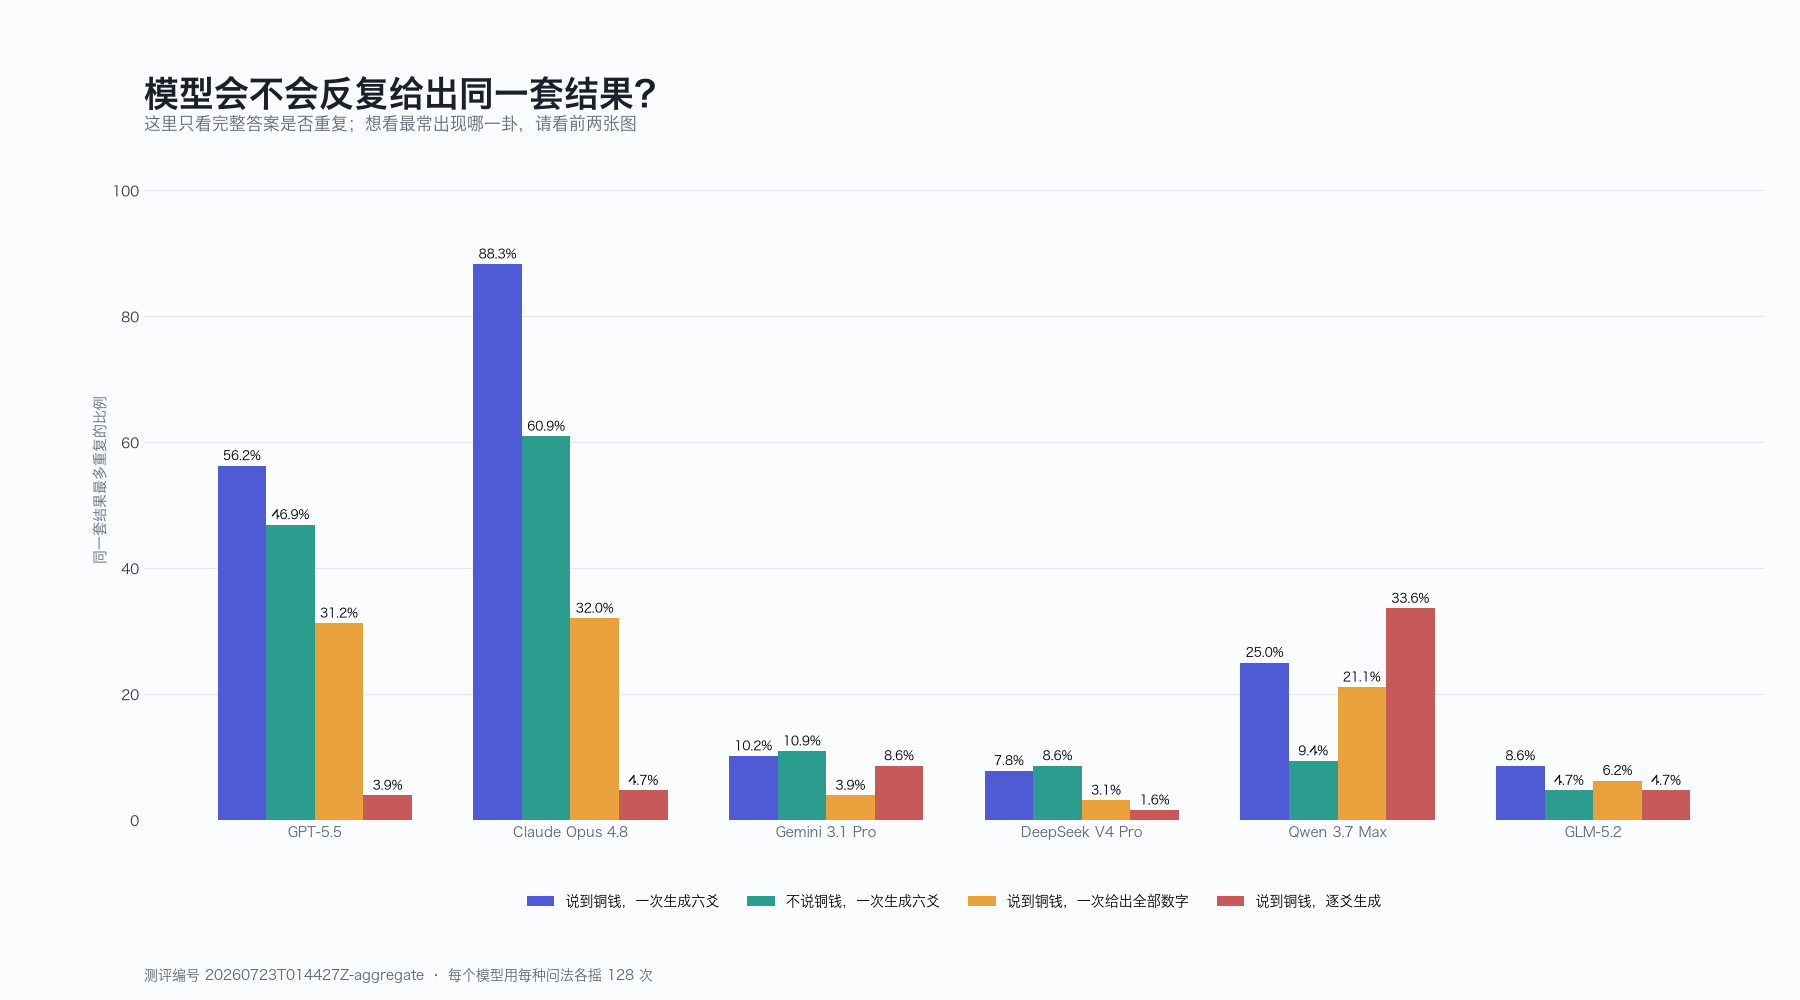
圖五:模板重複越高,說明結果越集中在少數固定的 0/1 寫法上。
這也解釋了為什麼“每次答案會變”仍然不等於“公平隨機”。一個模型可以在幾個高概率模板之間變化,但只要這些模板被選擇的機會不相等,最終卦象就不會均勻。
為什麼大模型會有這些偏好
數據能直接證明“出現了偏好”和“偏好會隨問法變化”。至於模型內部為什麼恰好偏向水火既濟、乾為天或風水渙,下面是與語言模型工作方式一致的解釋,但不是對隱藏參數的直接觀測。
1. 每一位不保證一半是 0、一半是 1
語言模型的基本動作是:根據前文,為下一個詞元分配概率,再進行隨機採樣。它會變化,但並沒有一條規則強制 0 和 1 各佔 50%。溫度等採樣參數只能改變分佈的平緩程度,不能自動把它變成公平硬幣。
2. 前後數字並不天然獨立
真實銅錢的下一次結果不應該被上一次影響;語言模型卻必須根據已經寫出的內容繼續寫。前一位是 0 還是 1、當前已經出現了什麼模式,都會改變下一位的概率。連續生成 18 位數字尤其容易形成重複、對稱或模型熟悉的序列。
3. 問法會改變模型正在續寫的文本
“請模擬三枚銅錢”和“只輸出 0/1”會喚起不同的語言上下文;一次寫完與逐爻請求又改變了生成邊界。模型處理的是文本條件概率,而不是抽象的銅錢實體,所以提示詞和輸出結構都會進入結果。
4. 訓練文本與對齊習慣可能提供先驗
乾、既濟、泰等卦在中文文化文本中有較高辨識度;“隨機數字”也常與交替、平衡、避免長串重複等人為直覺一起出現。這些訓練痕跡可能影響數字續寫。但僅憑本次輸出,不能斷言某個具體卦是由哪一批訓練材料造成的,這一點仍需要更細的機制實驗。
這次實驗能說明什麼,不能說明什麼
它能說明:
- 在本次實際路由的六個模型、四種問法和採樣設置下,生成的卦象明顯不是均勻分佈;
- 六個模型都出現了自己的高頻卦;
- 同一模型換一種問法,偏好的卦和集中程度會明顯變化;
- 因而,不能把語言模型直接生成的 0/1 當成三枚公平銅錢。
它不能說明:
- 模型“永遠”偏愛某一卦。模型版本、路由、採樣參數和提示詞變化後,結果可能變化;
- 某個模型更聰明或更適合解卦。這裡測的是生成隨機結果的行為,不是推理或解釋能力;
- 已經定位了每一種偏好的唯一內部原因。本實驗觀察到現象,機制解釋仍需要更多對照;
- 真實起卦或卦義本身是否有效。這不是本次測評的問題。
如果目標是公平起卦,更可靠的做法很簡單:用真實銅錢,或用經過檢驗的隨機數來源生成卦,再讓大模型負責解釋。“生成卦”和“解讀卦”是兩種工作,不應該因為都能由 AI 輸出文字就混為一談。
原始數據與複核材料
為了讓結論可以復算,這次公開三個層級的文件:
- 3,072 條有效結果 CSV:每一條完整卦的模型、問法、六爻結果和卦名;
- 機器可讀彙總 JSON:總體、按問法、按模型以及 24 個組合的完整計數;
- 離線審計報告 HTML:實驗批次、實際路由模型、統計圖和方法說明。
圖表全部由這些有效結果直接統計生成,沒有用圖片生成模型重畫數據。你可以下載 CSV 自己分組計數;每個模型應為 512 條,每種問法應為 768 條,每個“模型 × 問法”組合應為 128 條,總數應為 3,072 條。
這次最值得記住的不是“哪一卦贏了”,而是:會變化,不等於公平隨機;模型的偏好,也會被我們的問法塑造。